左值和右值是理解现代 C++ 性能模型的一把钥匙:它决定了对象会在什么时候被拷贝、什么时候能把资源”偷”过来,也是后续理解完美转发、std::forward 的前置知识。
本文按下面这条线索展开:
- 什么是左值、什么是右值——回归 C++98 的值类别,并给出一个可操作的判断法则;
- 为什么要有移动语义——临时对象带来的拷贝冗余,以及编译器优化的能力边界;
- 移动语义——右值引用、
std::move与使用时的注意事项; - C++11 之后的值类别体系——把左值/右值重新拆分成
lvalue/xvalue/prvalue三类。
一、左值和右值
左值和右值的概念在 C++98 就已经存在,只是当时标准的表述比较模糊。它是一个针对表达式的概念——讨论的不是”变量”,而是”这个表达式算出来的东西”。
1.1 左值(lvalue)
一般来说,左值是指一个指向特定内存的、具有名称的值:它有一个相对稳定的内存地址,表示一个有身份(identity)的对象,我们可以对它取地址。
1.2 右值(rvalue)
右值表示指向不稳定内存地址的匿名值:生命周期很短,通常是暂时性的,用完即弃,编译器不允许对它取地址(但依然会为其分配存储空间)。
1.3 一个简单判断法则:能不能取地址
既然核心差异在于”有没有稳定的身份”,那么一个很好用的判断方式就是:
能对表达式取地址 → 左值;不能取地址 → 右值。
参考下面这组例子:
1 | // 字面量一般是 rvalue |
1.4 C++11 之前:值类别只服务于语法合法性
任何表达式不是左值就是右值:要么关联了一个可以被找到的值,要么关联了一个找不到(无法取地址)的值。
在 C++11 之前,这套体系的核心作用是确保操作的合法性:
- 赋值运算符左侧必须是左值;
- 取地址操作只能用于左值。
1 | int a = 10; |
不合法的地方编译器会报错,但左值/右值并没有被用来提升程序性能。直到 C++11,这个概念才被扩充,并真正成为性能优化的抓手。
二、问题:冗余拷贝
2.1 临时对象是拷贝开销的核心来源
随着程序复杂度提升,运行过程中会产生大量的拷贝开销,而右值对象正是这些开销的核心来源。
典型场景是:一个右值对象的生命周期在语句结束后就结束了,在此之前它的值被拷贝进某个具名对象,然后右值被销毁。整个过程付出了完整的拷贝代价,却没有产生额外价值——这份拷贝是纯冗余的。
2.2 编译器的拷贝优化,以及它的局限
针对这种冗余,很多编译器会做优化:
1 | void fun(ClassA ca) {} |
但这始终只是编译器的自发行为,存在两个明显局限:
- 优化不了的情况:一旦代码足够复杂,编译器无法确认语义是否允许省略拷贝,就不会优化;
- 想主动优化的情况:有时候我们明确希望”偷走”某个左值的资源(例如把一个不再使用的局部容器塞进另一个容器),编译器不会替我们做这个决定。
于是,C++11 出手了。
三、移动语义(C++11)
C++11 引入移动语义,为”拷贝右值”和”移动左值”这两类场景提供了更精准、更通用的优化方案。
核心思想:当一个对象处于”即将销毁”或”不再需要”的状态时,不再拷贝它的数据,而是允许新对象直接接管其资源,从而消除拷贝开销。
3.1 右值引用 T&&
要接管资源,首先得在类型层面把”可以接管的右值”识别出来。C++11 新增了右值引用 T&&,它只能绑定到右值:
1 | int&& r1 = 42; // OK:绑定到一个纯右值 |
有了 T&&,就可以为同一个类同时重载出拷贝构造(接受 const T&)和移动构造(接受 T&&),让编译器根据实参的值类别自动选择:右值走便宜的移动,左值走安全的拷贝。
3.2 示例:移动构造到底省了什么
下面这个例子用打印语句直观展示拷贝与移动的区别:
1 |
|
可以看到:拷贝是”重新分配 + 复制数据”,移动只是”接管指针 + 把源指针置空”。对于持有堆内存、文件句柄、socket 等资源的类型,收益非常可观(STL 容器、std::string、std::unique_ptr 都已实现移动语义)。
3.3 std::move:让左值也能触发移动
移动语义在右值对象上天然自动生效;而对左值,需要程序员显式使用 std::move 来授权:
std::move不做任何移动动作,它只是一个类型转换(static_cast<T&&>);- 它不改变对象本身的左值属性,只是给编译器加了一个”可以把我当右值看待”的标记;
- 调用之后,编译器在这个表达式上就会选择移动构造 / 移动赋值。
3.4 使用注意事项
- 被移动后的对象仍然有效,但处于”未指定状态”:可以析构、可以重新赋值,但不要再依赖它原有的值。上例中我们在移动构造里把
other.data_置空,正是为了让它析构时安全。 - 不要滥用
std::move:对还要继续使用的对象move,会导致数据意外丢失。 - 移动构造尽量声明为
noexcept:std::vector扩容时只有在移动操作不抛异常时才敢使用移动,否则会退化为拷贝。 - 函数的返回值不要加
std::move:这会抑制编译器的 RVO/NRVO 优化,反而多一次移动。
通过移动语义可以显著降低拷贝开销,但代价是 C++98 那套”左值/右值”二分法不够用了——因为 std::move 让一个左值也能被当作右值处理。值类别体系因此被重新划分。
四、C++11 之后的值类别体系
C++11 把表达式的值类别从两类细分为三类,再归并成两个大类:
| 值类别 | 是否有身份(可取地址) | 是否可被移动 | 典型例子 |
|---|---|---|---|
lvalue 左值 |
是 | 否 | 变量名、返回 T& 的函数调用、++x、*p、字符串字面量 |
xvalue 将亡值 |
是 | 是 | std::move(x)、返回 T&& 的函数调用 |
prvalue 纯右值 |
否 | 是 | 除字符串外的字面量、x++、返回非引用类型的函数调用 |
它们的关系是:
- 广义左值(glvalue) =
lvalue+xvalue:有身份,可取地址。lvalue:对应 C++11 之前的左值,有身份,不可移动;xvalue:被std::move标记为T&&的左值,有身份,可移动(”将亡”,即将被销毁)。
- 广义右值(rvalue) =
xvalue+prvalue:可以作为T&&的绑定目标,可被移动。prvalue:对应 C++11 之前的右值,没有身份;xvalue:同样属于右值,但它有身份——正因为如此,这套体系才能把”有没有身份”和”能不能被移动”这两个正交维度同时表达出来。
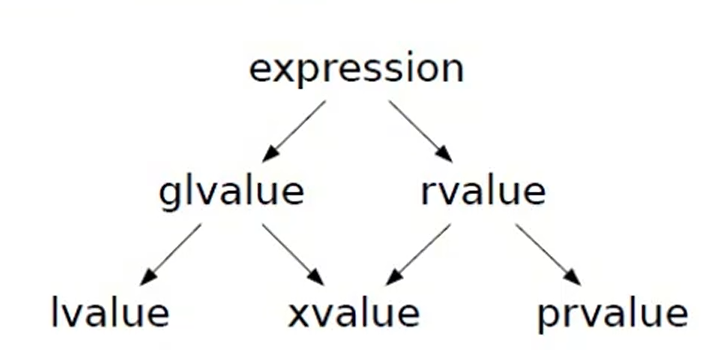
能否被移动 = 是不是广义右值,能否取地址 = 是不是广义左值。 xvalue 同时满足两者。