程序运行时所“看到”的内存,并不是物理内存的原始模样,而是由操作系统、编译器和链接器共同规划出的一套虚拟地址空间。理解这套布局,是写出高效、安全 C++ 代码的基础——它解释了变量为什么会被放在不同的位置、指针为什么会有不同的权限、以及同样的算法在内存访问方式不同时为何性能差距巨大。
本文将从整体到局部,逐层剖析 C++ 程序的内存布局:先看三大区域的构成,再逐个拆解每个分段的职责与特性,最后通过实测代码观察 64 位系统下的真实地址分布,并解释现代操作系统为何放弃了教科书中的经典模型。
一、内存空间的整体构成
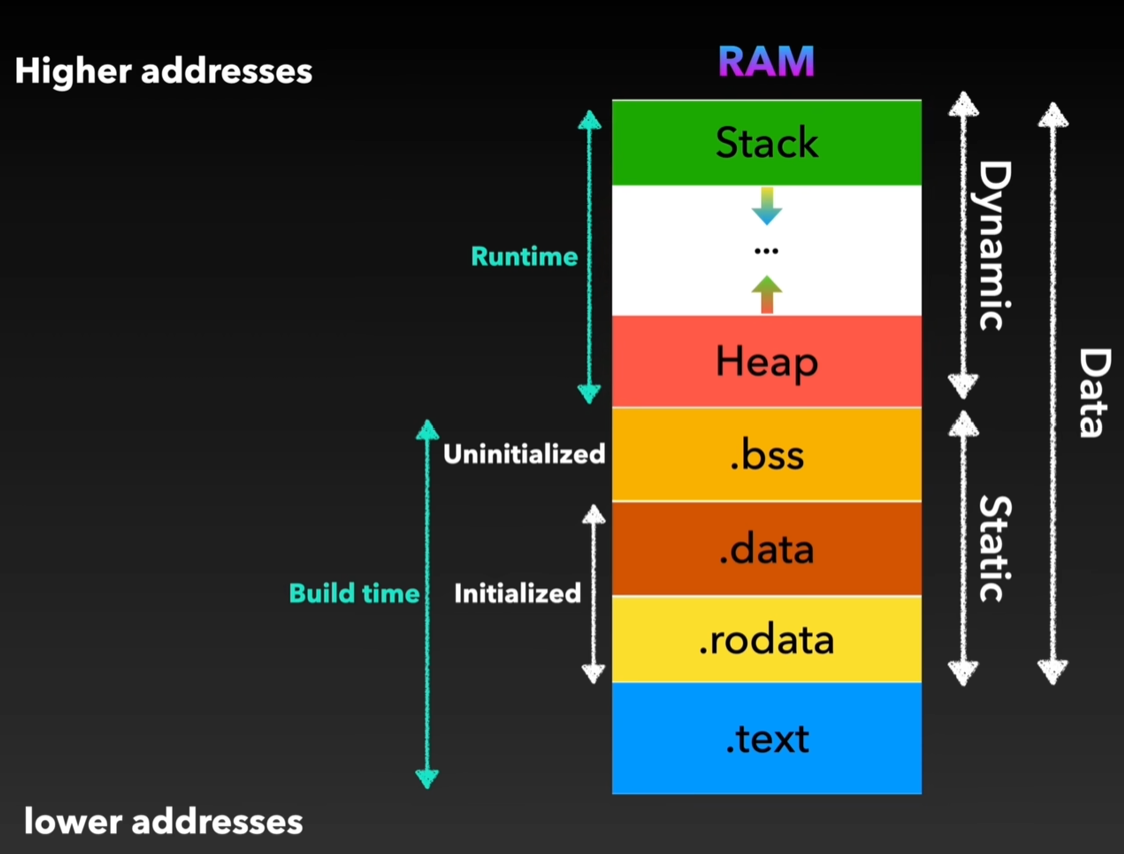
程序的内存空间主要由 3 大区域 构成:代码段、静态数据区 和 动态数据区。
其中:
- 代码段:又称为文本段,通常记为
.text。 - 静态数据区:在编译链接阶段就已确定,进一步细分为只读数据段
.rodata、数据段.data和.bss段。.rodata存放已初始化的只读常量;.data存放已初始化的非零变量;.bss为所有未初始化或值为 0 的变量预留空间。
- 动态数据区:在运行时才划分,分为堆区和栈区。
关于分段命名的约定
代码段和静态数据区的名字都带有 . 前缀,是因为它们是在编译链接阶段就已确定、存在于可执行文件中的具名段。这一命名约定起源自汇编器,用于标记这些由构建工具链管理的特殊名称。在 macOS 上,同样的段则使用双下划线 __ 作为前缀(如 __TEXT、__DATA)。
与之相对,堆和栈是纯粹运行时的内存区域,在可执行文件中并没有对应的具名段——它们只在程序被加载并运行之后才真正存在。
二、经典布局:虚拟地址空间中的排列顺序
在程序的虚拟地址空间中,传统的布局设计依次为:代码段、只读数据段、数据段、BSS 段、堆;而栈位于整个程序空间的最顶端。
为实现空间的最大化利用,堆区从程序内存的低地址向上生长,而栈区从内存的高地址向下生长,两者共享动态内存区域中间那段可用的空闲空间。
其中,文本段和静态数据区在程序编译和链接阶段就已经确定,占用一段固定大小的内存空间:
- 它们由编译器自动进行分配和释放,程序员既无需、也无法手动干预;
- 它们的内存布局在编译链接阶段就已经由编译器规划完毕。
三、编译期确定的区域
3.1 代码段(.text)
文本段 .text 也称代码段,存放源代码经过编译后对应的 CPU 指令,即机器码。其内容由可执行文件加载而来,大小在编译链接阶段便已确定,在整个程序运行期间保持不变。
同时,操作系统会赋予该区域只读权限,以确保 CPU 能安全地读取并执行程序逻辑——任何试图写入代码段的行为都会被操作系统拦截。
3.2 静态数据区
静态数据区共有三个分段,我们依次来看。
BSS 段(.bss)
BSS 的全称为 block started by symbol,用于存放所有未初始化或初始化为 0 的全局静态变量。其大小在编译时确定,在运行时可读可写。
BSS 的核心设计理念之一是:只在内存中预留位置,但不在文件中保存实体。也就是说,编译器在生成可执行文件时,并不会将这些变量的大量零值实实在在地写入文件,而仅仅记录下它们的名称、大小等元信息。当操作系统加载程序时,再读取这些元信息,在内存中预留出相应的空间,并将其全部置零。
这样做的好处是为大型未初始化数据节省磁盘空间——比如一个未初始化或者初始化为 0 的大型数组,它在磁盘上的开销几乎可以忽略不计。
初始化数据区(.data 与 .rodata)
对于初始化数据区,程序加载时这块区域的大小在构建阶段就已经被完全确定下来,并且这个大小会从可执行文件中直接复制到内存。
根据能否在运行时修改的属性,该区域可分为可读写的 .data 段和只读的 .rodata 段:
.data段:存放所有初始值不为 0 的全局变量和静态变量。因为它们是变量,所以这块内存区域在程序运行时是可读可写的。.rodata段:存放常量数据,即用const修饰的变量和字符串字面量。这块内存会被操作系统保护起来,变成只读状态,任何试图修改它的行为都会直接导致程序崩溃。
有兴趣的小伙伴可以自行尝试:定义一个字符串字面量并尝试写入它,观察程序是如何崩溃的。
分段职责一览
| 分段 | 存放内容 | 访问权限 | 是否占用可执行文件空间 |
|---|---|---|---|
.text |
编译后的 CPU 指令(机器码) | 只读、可执行 | 是 |
.rodata |
const 变量、字符串字面量 |
只读 | 是 |
.data |
已初始化且初值不为 0 的全局/静态变量 | 可读可写 | 是 |
.bss |
未初始化或初值为 0 的全局/静态变量 | 可读可写 | 否(仅记录元信息) |
四、运行期划分的区域:动态数据区
与静态区域不同,动态内存区是在程序运行时进行分配和管理的,它包含栈和堆两部分。
4.1 栈(Stack)
栈是一块由编译器进行自动化管理的区域,用于局部变量的存储和函数调用。
- (a) 工作机制:它严格遵循后进先出(LIFO)的数据结构原则。当函数被调用时,其对应的栈帧(一个包含该函数所有局部变量、参数和返回地址等信息的内存块)被压入栈顶;当函数执行结束,该栈帧被整体弹出,其所占内存瞬间被回收。
- (b) 优点:这种自动化的管理机制使得栈的内存分配和释放速度极快,且从根本上杜绝了内存泄露的可能。
- (c) 缺点:空间大小在编译时已固定且通常较小,并且其上所有数据的生命周期都被严格限制在函数的作用域内。
- (d) 注意事项:对于递归代码,必须要有可以收敛的基线条件(也就是递归的终点),否则会导致无限递归,发生**栈溢出(stack overflow)**错误。
4.2 堆(Heap)
堆是用于动态分配的内存区,它提供了巨大且灵活的空间,可以由程序员手动申请和管理。但是,主动申请的内存一旦忘记释放,就会导致内存泄露。
在 C 语言中,你可以使用 malloc 和 free 进行内存的申请和释放;在 C++ 中则对应 new 和 delete 操作。C++ 的 new / delete 除了管理内存本身,还会调用对象的构造函数与析构函数,这一点是它与 malloc / free 的本质区别。
4.3 堆内存连续与否,为什么会影响性能
堆内存的组织方式是连续还是分散,对程序性能会有明显影响,原因在于 CPU 缓存:CPU 在读取内存时,会一次性地将目标数据及其邻居一同加载到高速缓存中。
- 因此,当遍历连续内存时,下一个元素大概率已在缓存中,这叫 “缓存命中”,速度极快;
- 而遍历分散内存(例如指针串联的链表节点)时,访问下一个节点需要重新去主内存读取,这叫 “缓存缺失”,速度会相对较慢。
这也就解释了为什么在追求极致性能的场景下,std::vector 这类连续存储的容器往往优于链表结构。
4.4 栈与堆对比
| 对比维度 | 栈(Stack) | 堆(Heap) |
|---|---|---|
| 管理者 | 编译器自动管理 | 程序员手动管理 |
| 分配/释放速度 | 极快(移动栈指针即可) | 相对较慢(需查找可用块) |
| 空间大小 | 编译期固定,通常较小 | 大且灵活 |
| 生命周期 | 受限于函数作用域 | 由程序员控制,直到显式释放 |
| 典型风险 | 栈溢出 | 内存泄露、悬垂指针、碎片化 |
五、实测:程序内各分段的相对地址
最后我们来看一下,在一个程序内运行时,它们的相对地址顺序又是如何呢?
1 |
|
通过在最新的 64 位操作系统上运行程序,测试一个程序内存布局中每一个分段的 16 进制起始地址,发现:从 .text 到 .bss,地址确实是从小到大依次排列的,即按照地址高低排序,打印如下:
1 | the result is |
5.1 引入变数的主角:ASLR
再次运行同一段代码,发现所有区域的基地址都发生了改变。这正是现代操作系统的安全卫士——地址空间布局随机化(Address Space Layout Randomization,简称 ASLR)。
它就像操作系统在每次运行程序前都帮你洗一次牌,随机化内存区的起始地址。这样一来,程序的内存地址只在单次运行时固定,攻击者便无法依赖固定的地址进行攻击,极大地提升了程序的安全性。
5.2 随机化也并非完全无序
但是,ASLR 也并非完全无序。通过多次代码实验可以发现:
- 栈的起始地址总是小于堆的起始地址;
- 静态区的起始地址永远小于堆和栈。
这是否意味着前面所讲的“栈 > 堆 > 静态区”的模型是错的呢?并非错误,而是模型背后的设计哲学已经演变了。
5.3 从 32 位到 64 位:设计哲学的演变
因为教科书的时代是 32 位系统的旧时代,虚拟地址空间一般只有 4 GB。设计者让栈从最高地址向下生长、堆从静态区之上向上生长,这样它们之间的剩余空间就可以尽可能的多。但是当内存使用过多时,它们还是可能相撞,造成内存不足。
然而在现代的 64 位系统中,虚拟地址空间大到近乎无限,撞车的风险已不复存在。因此,操作系统获得了更大的自由度,不再需要 32 位那样紧凑的设计。ASLR 会分别在几个宏观的地址范围内进行随机化:
- 静态内存区被随机放置在一个相对较低的地址范围;
- 堆和栈则被分别随机放置在更高的地址范围。
这就是为什么代码运行结果中观察到的静态区地址总是最小。
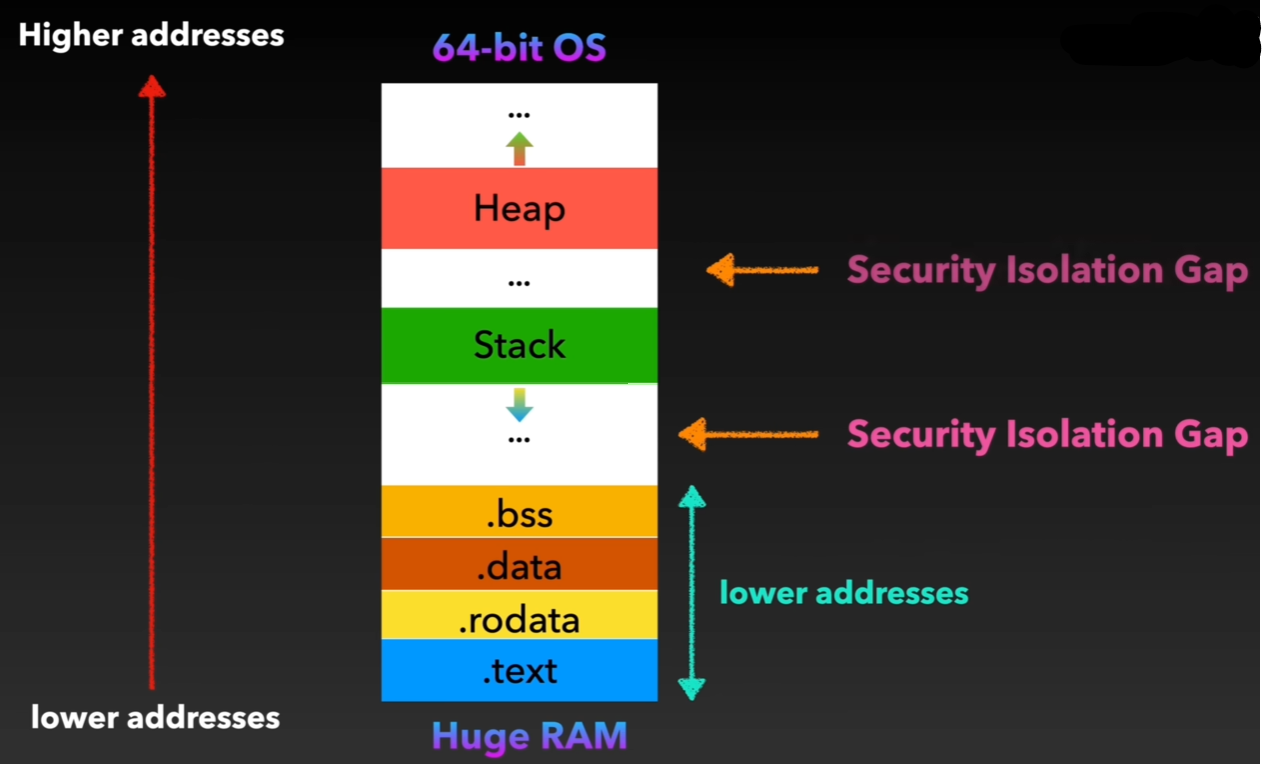
由于虚拟空间足够巨大,堆和栈之间有广阔的安全隔离带,它们永远不可能相遇。这种以空间换取安全性和降低内存复杂度的布局,正是现代操作系统的选择。
六、小结
- 程序内存由代码段、静态数据区、动态数据区三大区域构成;
.text存放机器码且只读;.rodata存放常量;.data存放初值非 0 的全局/静态变量;.bss存放未初始化或初值为 0 的变量,且不占用可执行文件体积;- 栈由编译器自动管理,快但小、生命周期受限;堆由程序员手动管理,大而灵活但易泄露,且其内存连续性会显著影响缓存性能;
- 32 位时代“栈与堆从两端向中间生长”的经典模型,在 64 位时代已演变为多个宏观地址区间各自随机化的布局,配合 ASLR 大幅提升了程序的安全性。