函数和神经网络
我们可以理解这个世界上所有的规律或者逻辑,知识都可以用函数f(x)表示。
符号主义
大概说说人工智能早期的思路:符号主义的思想。但是很多任务我们不知道如何去找到那个f(x),比如图像识别。所以人们转换了思路。
联结主义
给定x与y如何寻找函数f(x)呢?既然f(x)难以寻找,那就寻找一个跟真正的答案大差不差的函数f(x),然后通过f(x)去逼近真实的答案。把门只要设计某种机制,让f(x)与真实值的差距可以保持在一个阈值以内,那么这个f(x)就跟真实值很接近了。简而言之,联结主义不再追求寻找真实答案,而是寻找一个近似的答案。
对于简单的接近线性的函数,我们可以用线性回归来逼近,举个线性回归的例子。
但是对于复杂的非线性函数使用简单的y=wx+b的线性模型是无法逼近的,所以需要引入非线性函数。怎么把这个线性函数变为非线性呢?只需要在这个线性的外面套一个非线性的运算,这个非线性的运算就叫做激活函数,f(x)=g(wx+b)。g就被称为激活函数,他把原来简单的线性关系给盘活了,成了非线性关系。常见的激活函数有sigmoid、tanh、ReLU等,虽然很简单,但是有论文表明可以起到很好的效果。
所以现在公式变为f(x) = g(wx+b),但是很多时候我们不止一个输入,那每个输入都要对应一个w,公式就变成了f(x1,x2) = g(w1x1+w2x2+b)。但是套一层激活函数可能在学习的时候没有办法学习更加多变的曲线规律。所以就需要多层的神经网络,也就是多层的感知机,我们把上一步的输出变为下一步的输入然后再套上一层激活函数,公式变为f(x1,x2,x3) = g(w1x1+w2x2+b) = g(w3g(w1x1+w2x2+b)+b2)。
按照上面那样就可以一直无限套娃,学习更加复杂的规律,理论上这套函数可以逼近任何复杂的连续函数。但是这种方法不是特别直观,为了直观,人们把f(x) = g(wx+b)看成一个神经元,把g(wx+b)看成一个神经元的输出,把wx+b看成一个神经元的输入。上面的三层神经元示意图如下:
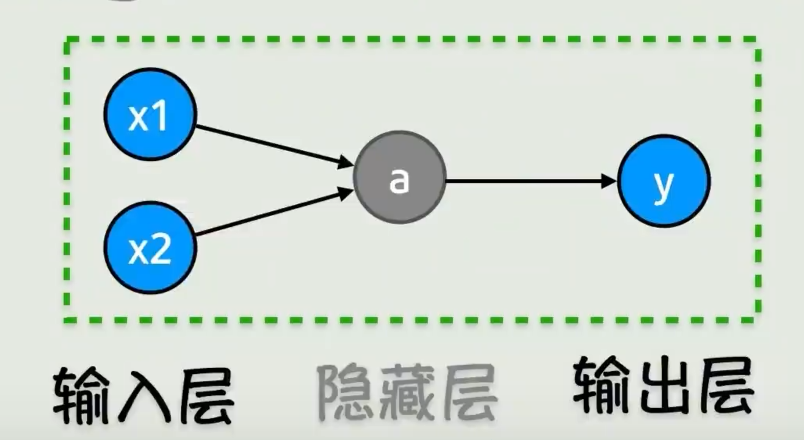
一层输入层,一层隐藏层,一层输入层,首先是输入层进行输入x1,x2,然后经过隐藏层计算得到g(w1x1+w2x2+b),然后这些又作为输入,经过输出层计算得到g(w3g(w1x1+w2*x2+b)+b2)。当我们把这个神经网络的输入,隐藏层层数,输出都调整的很深的时候,这个神经网络就可以模拟出一个非常复杂的函数了。
虽然神经网络看上去很复杂,但是其实做的任务很简单,就是根据一些已知的x和y去猜测这个结构中的w和b,猜测这个神经网络中各个参数的数值,使得它运行起来基本可以跟真实值相近。
神经网络的参数是什么
to be continued…